BioGPT
AI cho nghiên cứu được huấn luyện chuyên biệt cho lĩnh vực sinh-y học và y-khoa (biomedical)

Nền tảng:

AI Dữ liệu
Market Data
Research AI
Data AI
Extraction

BioGPT là gì?

BioGPT là một mô hình ngôn ngữ dạng Transformer được tiền huấn luyện (pre-trained) chuyên biệt cho lĩnh vực sinh-y học và y-khoa (biomedical). Nó có khả năng sinh văn bản và khai thác thông tin từ các bài báo, tóm tắt điều khoản nghiên cứu, trả lời câu hỏi y-khoa, phân tích mối quan hệ giữa thuốc-đích-đích chuyển hóa, v.v.
BioGPT 2

Thông tin cơ bản

  • Tên: BioGPT (cũng có phiên bản lớn hơn gọi là BioGPT-Large)

  • Nhà phát triển: Microsoft Research (một nhóm nghiên cứu tại Microsoft)

  • Kiến trúc: dựa trên GPT (cụ thể là GPT-2) với điều chỉnh cho dữ liệu y-khoa.

  • Dữ liệu huấn luyện: Khoảng 15 triệu đầu mục tóm tắt (abstracts) từ PubMed (ngành sinh-y khoa)

  • Mục tiêu người dùng: nhà nghiên cứu sinh-y học, y-khoa, phân tích dữ liệu y tế, hệ thống hỗ trợ trả lời câu hỏi y-khoa, khai thác tri thức từ văn bản nghiên cứu.

Điểm nổi bật

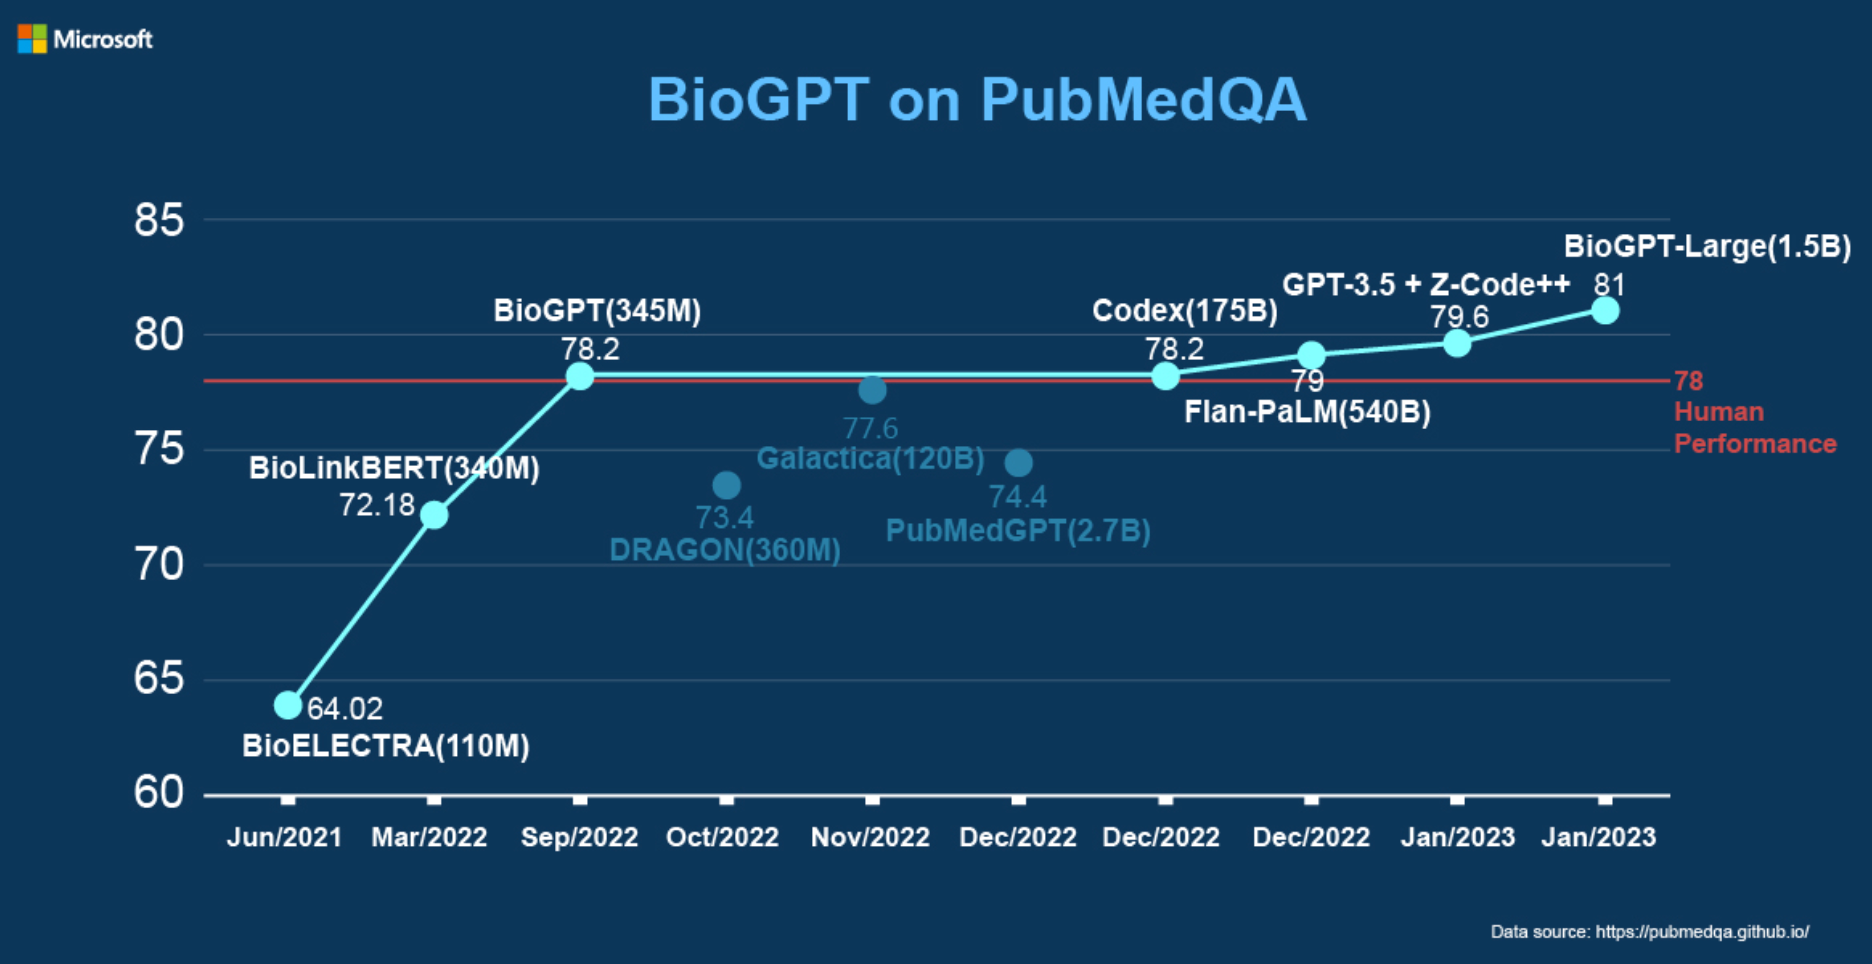
  • Đạt hiệu suất rất tốt trên nhiều tác vụ chuyên biệt trong lĩnh vực y khoa — ví dụ: tác vụ trả lời câu hỏi (question answering) trên bộ dữ liệu PubMedQA, BioGPT đạt ~78.2% (với phiên bản thường) và ~81.0% với BioGPT-Large.

  • Có khả năng sinh văn bản chuyên biệt cho lĩnh vực y-khoa (ví dụ: mô tả các thuật ngữ, liên kết thuốc-đích, tạo nội dung nghiên cứu) chứ không chỉ làm phân loại hay dự đoán như nhiều mô hình y-khoa khác.

  • Được phát hành mã nguồn và checkpoint dưới giấy phép MIT — nghĩa là dùng tương đối linh hoạt cho nghiên cứu và ứng dụng (phải tuân theo giấy phép)

  • Thích hợp để tích hợp trong các pipeline nghiên cứu sinh-y học, khai thác dữ liệu lớn y-khoa hoặc làm nền tảng cho các ứng dụng y-khoa AI.

Điểm mạnh

  • Chuyên biệt lĩnh vực: Vì được huấn luyện trên dữ liệu y-khoa lớn nên hiểu được ngôn ngữ chuyên ngành, thuật ngữ, cấu trúc nghiên cứu hơn nhiều mô hình “chung chung”.

  • Khả năng sinh và khai thác: Không chỉ phân loại, mà còn có thể sinh văn bản, tạo tóm tắt, tạo kết nối thông tin nghiên cứu — hữu ích cho các nhà khoa học/nhà nghiên cứu.

  • Mã mở & giấy phép tương đối thân thiện: Checkpoint và mã có sẵn trên GitHub với MIT license, giúp việc triển khai, tùy biến dễ hơn.

  • Được đánh giá cao trên nhiều benchmark y-khoa: Như extraction (trích xuất quan hệ), QA (trả lời câu hỏi) — chứng tỏ hiệu quả trong lĩnh vực chuyên biệt.

Điểm yếu

  • Kiến thức bị giới hạn: Mặc dù huấn luyện trên nhiều dữ liệu y-khoa, nhưng vẫn có giới hạn về thời gian (dữ liệu đến thời điểm huấn luyện) và khả năng hiểu biết sâu sắc như chuyên gia con người. Ví dụ: Một số phân tích cảnh báo mô hình này có thể “halucinate” (sinh thông tin không chính xác) nếu dùng ngoài phạm vi huấn luyện chính.

  • Yêu cầu kỹ thuật: Để triển khai và sử dụng hiệu quả cần có kiến thức về lập trình, xử lý NLP, mô hình Transformer, nền tảng phần cứng (GPU) nếu dùng phiên bản lớn.

  • Không phải là giải pháp “plug-and-play” cho mọi ứng dụng y-khoa: Cần tùy biến, fine-tune, và kiểm thử kỹ lưỡng (đặc biệt nếu sử dụng cho ứng dụng lâm sàng / y tế) vì rủi ro sai lệch thông tin rất lớn.

  • Chi phí và tài nguyên: Phiên bản lớn hoặc ứng dụng trong môi trường sản xuất có thể cần nguồn lực đáng kể: GPU mạnh, lưu trữ, bảo mật dữ liệu y tế, tuân thủ pháp lý.

  • Rủi ro về trách nhiệm: Trong lĩnh vực y-khoa, việc sử dụng mô hình AI sinh văn bản cần được kiểm soát rất chặt — thông tin sai lệch có thể gây hậu quả nghiêm trọng.

Hướng dẫn sử dụng

  1. Cài đặt môi trường: Cần Python (ví dụ 3.10), PyTorch, fairseq hoặc sử dụng thư viện Transformers của Hugging Face Transformers. Ví dụ từ GitHub: yêu cầu PyTorch 1.12.0, fairseq 0.12.0.

  2. Tải mô hình: Sử dụng checkpoint từ GitHub hoặc tải từ Hugging Face: microsoft/biogpt hoặc microsoft/biogpt-large.

  3. Khởi tạo tokenizer & model: Ví dụ sử dụng Transformers:

    from transformers import BioGptTokenizer, BioGptForCausalLM, pipeline
    tokenizer = BioGptTokenizer.from_pretrained("microsoft/biogpt")
    model = BioGptForCausalLM.from_pretrained("microsoft/biogpt")
    generator = pipeline("text-generation", model=model, tokenizer=tokenizer)
    result = generator("Ibuprofen is best used for", max_length=50, do_sample=True)
    print(result[0]["generated_text"])


  4. Fine-tune hoặc tùy biến (nếu cần): Nếu bạn có dữ liệu chuyên biệt (ví dụ văn bản nghiên cứu nội bộ, hệ thống y tế, hợp đồng nghiên cứu) — có thể fine-tune BioGPT cho các tác vụ như extraction, QA, summarization.

  5. Triển khai và kiểm thử: Sau khi có mô hình, triển khai vào hệ thống (API, backend ứng dụng), kiểm thử với dữ liệu thực tế, đảm bảo tính chính xác, không bỏ lỡ/ngộ nhận thông tin.

  6. Giám sát & bảo trì: Vì kiến thức y-khoa luôn cập nhật, bạn cần theo dõi hiệu suất mô hình, cập nhật dữ liệu hoặc tái huấn luyện định kỳ nếu cần, và kiểm soát các rủi ro (ví dụ: thông tin sai, hallucinaton).

  7. Tuân thủ pháp lý/đạo đức: Nếu sử dụng trong môi trường lâm sàng/đối với người bệnh — cần đảm bảo tuân thủ GDPR, HIPAA (nếu Mỹ), luật bảo mật dữ liệu y tế, và thường có cần phê duyệt nội bộ hoặc tổ chức chuyên môn.

Giá cả chung

  • Vì BioGPT là mô hình mã nguồn mở (MIT license) và có checkpoint miễn phí từ Microsoft/Hugging Face, bản thân mô hình không có “giá định sẵn” cho licence.

  • Tuy nhiên, chi phí thực tế sử dụng sẽ bao gồm: tài nguyên phần cứng (GPU/TPU, điện), thời gian phát triển/kỹ thuật, lưu trữ dữ liệu, triển khai và duy trì – có thể là con số không nhỏ nếu dùng cho môi trường sản xuất.

  • Nếu bạn mua dịch vụ từ bên thứ ba (ví dụ triển khai cloud, API form) có thể sẽ có mức phí riêng; nhưng thông tin công khai cho BioGPT như phần mềm thương mại chưa rõ ràng — Microsoft chỉ cung cấp mô hình nghiên cứu.

  • Tóm lại: mô hình miễn phí để bắt đầu, nhưng chi phí chủ yếu từ triển khai và vận hành.

Kết luận

BioGPT là một công cụ rất mạnh dành cho lĩnh vực sinh-y học/ y-khoa khi bạn cần khai thác văn bản lớn, sinh mô tả chuyên ngành, hỗ trợ QA hoặc extraction trong nghiên cứu. Nếu bạn là nhà nghiên cứu, hoặc tổ chức có nền tảng dữ liệu lớn và muốn chuyên biệt hóa AI cho lĩnh vực y tế — BioGPT là lựa chọn tốt.

Tuy nhiên — nếu bạn chỉ cần một mô hình AI chung chung để viết blog hoặc ứng dụng tiêu dùng – BioGPT có thể không cần thiết và hơi “thừa” về chuyên môn. Đồng thời, khi dùng cho ứng dụng y-khoa thực tế, bạn cần kiểm soát rất chặt rủi ro sai lệch thông tin và tuân thủ pháp lý.

Công cụ thay thế

Databox là nền tảng business intelligence, data analytics và p...
#Data AI
#AI Dữ liệu
Manus là một nền tảng AI Agent được thiết kế để không chỉ trả ...
#Presentation
#Website Builder
Công cụ hỗ trợ nghiên cứu học thuật, dùng để khám phá, trực qu...
#Research AI
#AI Dữ liệu
Đánh giá, tổng hợp, kiểm tra tài liệu – dễ dàng “hiểu rõ hơn” ...
#Viết luận
#Research AI
Phần mềm quản lý tài liệu tham khảo và trích dẫn tự động — giú...
#Viết luận
#Research AI
Công cụ tìm kiếm và tổng hợp nghiên cứu học thuật sử dụng trí ...
#Viết luận
#Research AI
Scroll to Top